Quand l’IA devient capable d’agir, comment savoir si l’on peut lui faire confiance ?
L'intelligence artificielle ne se limite plus à produire des réponses. Elle commence à utiliser des outils, transformer des documents, exécuter des opérations et participer à l'organisation du travail.
Souhaitez-vous écouter cet article ?
Lecture uniquement sur demande. La qualité des voix dépend du navigateur.
Quand l’IA devient capable d’agir – Enquête croisée sur l’intelligence artificielle locale, les agents autonomes, la cybersécurité PHP et la fiabilité des mesures scientifiques.
- 1. Quand la science remet en question ses propres instruments
- 2. Les agents IA locaux : produire un résultat plutôt qu’une réponse convaincante
- 3. Quand les agents IA deviennent des collaborateurs numériques
- 4. PHP2Shell : quand une vulnérabilité ancienne devient une menace critique
- 5. Quatre domaines, une même question : où se trouve la preuve ?
- 6. Applications concrètes pour des outils numériques souverains
- Conclusion — L’avenir de l’IA dépendra aussi de notre capacité à la vérifier
- Sources et références
ATOOLPHA — Analyse technologique | 7 novembre 2026
L’intelligence artificielle connaît une évolution décisive. Longtemps cantonnée à la génération de textes, d’images ou de réponses conversationnelles, elle commence désormais à intervenir directement dans des processus professionnels : analyser des fichiers, produire du code, organiser des opérations, vérifier des résultats et coordonner plusieurs outils.
Cette transformation s’accompagne d’une promesse séduisante : des systèmes capables de travailler plus rapidement, avec davantage d’autonomie et, parfois, sans dépendre d’infrastructures cloud externes.
Mais derrière ces avancées apparaît une interrogation fondamentale : comment distinguer une technologie réellement fiable d’un système qui donne simplement l’impression de fonctionner ?
Quatre publications récentes permettent d’examiner cette question sous des angles complémentaires.
Une étude universitaire évalue les performances d’agents IA exécutés localement. Une enquête journalistique observe la collaboration entre salariés et agents autonomes. Une analyse de cybersécurité revient sur deux vulnérabilités critiques de PHP. Enfin, une recherche publiée dans Nature remet en question les méthodes utilisées pour mesurer une capacité cognitive humaine.
Ces travaux appartiennent à des domaines très différents. Pourtant, ils soulèvent un même problème : une mesure, une démonstration ou une promesse ne constitue pas automatiquement une preuve.
Pour comprendre les enjeux de l’IA de demain, il faut donc examiner non seulement ce que les systèmes réalisent, mais aussi la manière dont leurs résultats sont établis.
1. Quand la science remet en question ses propres instruments
Le 28 octobre 2026, la revue scientifique Nature publie une étude intitulée Emotion regulation capacity lacks a shared neural signature.
Cette recherche porte sur la réévaluation cognitive, un mécanisme qui consiste à modifier l’interprétation d’une situation pour en influencer l’impact émotionnel.
Les chercheurs se sont intéressés à une question méthodologique : les différentes méthodes utilisées pour mesurer cette capacité décrivent-elles réellement un même phénomène ?
Ils ont analysé 40 ensembles de données d’imagerie cérébrale fonctionnelle, représentant jusqu’à 2 175 participants.
Trois familles d’indicateurs ont été comparées : les questionnaires décrivant les habitudes déclarées des participants, les évaluations de leurs réactions émotionnelles pendant des exercices et les variations d’activité de certaines régions cérébrales, notamment l’amygdale.
Le résultat remet en cause une hypothèse largement utilisée : ces indicateurs ne convergent pas vers une mesure commune clairement identifiable.
Autrement dit, une personne peut présenter certains résultats à un questionnaire sans que ceux-ci correspondent nécessairement aux observations obtenues par une autre méthode.
Cela ne démontre pas que la réévaluation cognitive est inefficace. Cela signifie que les instruments étudiés ne permettent pas, à eux seuls, de tirer certaines conclusions sur les capacités individuelles.
Un enseignement qui dépasse les neurosciences
Cette découverte soulève une question essentielle pour le développement informatique : mesurons-nous réellement ce que nous prétendons mesurer ?
Un logiciel pédagogique peut enregistrer le nombre de réponses correctes à un exercice. Cette donnée est parfaitement légitime.
En revanche, affirmer que ce score représente l’intelligence générale, l’autonomie intellectuelle ou la capacité globale de raisonnement de l’utilisateur exigerait des preuves supplémentaires.
La même prudence doit s’appliquer aux systèmes d’intelligence artificielle.
Un chatbot peut produire une réponse grammaticalement irréprochable, sans que son contenu soit exact.
Un agent peut générer un programme informatique, sans que celui-ci soit exécutable.
Une IA peut réussir un test de connaissances, sans être capable d’accomplir correctement une tâche professionnelle réelle.
Ces résultats ne doivent pas être confondus.
De la performance affichée à la performance démontrée
Pour évaluer un système informatique, il faut distinguer au minimum trois dimensions.
La première concerne son comportement observable : a-t-il produit une réponse, effectué un calcul ou généré un document ?
La deuxième concerne la validité du résultat : le document respecte-t-il le format demandé, le calcul est-il correct, le programme fonctionne-t-il ?
La troisième concerne sa fiabilité : le système parvient-il à reproduire un résultat satisfaisant dans des conditions comparables, sans introduire des erreurs imprévisibles ?
Ces dimensions sont liées, mais elles ne sont pas équivalentes.
C’est précisément ce qui rend l’étude scientifique intéressante pour les concepteurs d’applications numériques. Elle rappelle qu’une mesure n’a de valeur que si son interprétation est justifiée.
Une approche rigoureuse consiste donc à définir d’abord ce qu’un système doit accomplir, puis les observations permettant d’en vérifier l’exécution, et enfin les limites de ce que ces observations permettent de conclure.
Cette distinction devient particulièrement importante lorsque l’intelligence artificielle n’est plus seulement chargée de répondre, mais également d’agir.
2. Les agents IA locaux : produire un résultat plutôt qu’une réponse convaincante
Le 8 octobre 2026, cinq chercheurs de l’Université d’Alicante publient sur arXiv une étude consacrée à l’évaluation des agents IA locaux dans des travaux d’ingénierie des données.
Son titre, Evaluating Local Language Model Agents for Reproducible Data Engineering, annonce un objectif particulièrement intéressant : déterminer si des modèles de langage exécutés sur une infrastructure locale peuvent produire des résultats corrects et reproductibles.
L’étude ne s’intéresse pas uniquement à la qualité des réponses textuelles. Elle examine des livrables concrets : scripts, tableaux, fichiers structurés, graphiques et rapports.
Les chercheurs ont construit un ensemble de 15 tâches, réparties entre plusieurs activités d’ingénierie des données, puis réalisé 1 500 essais au total.
Dix configurations locales ont été évaluées, avec deux modes de fonctionnement : une génération directe, sans possibilité d’itération, et un environnement permettant à l’agent de consulter des fichiers, exécuter des opérations, observer les erreurs et corriger sa production.
Des résultats qui changent la perspective
Les différences mesurées sont importantes.
Dans les conditions de cette expérience, le modèle Qwen 3.5 4B quantifié atteint 37,3 % de réussite lorsqu’il dispose de l’environnement de travail interactif.
Le modèle Qwen 3.5 9B quantifié atteint 69,3 %.
La meilleure configuration évaluée, Qwen 3.6 27B quantifié, atteint 85,3 %.
Mais le résultat le plus révélateur concerne l’évolution du modèle Qwen 3.5 9B entre les deux modes expérimentaux.
Sans environnement interactif, son taux de réussite s’établit à 17,3 %. Avec l’environnement permettant l’inspection, l’exécution et la correction des résultats, il atteint 69,3 %.
Cela représente une progression de 52 points de pourcentage.
Attention cependant à l’interprétation : cette augmentation caractérise l’ensemble de la configuration expérimentale. L’étude ne démontre pas que l’accès aux outils, considéré isolément, explique toute la différence.
Ces chiffres ne sont pas davantage des taux de réussite universels applicables à tous les domaines professionnels. Ils proviennent d’un protocole précis, comportant des tâches déterminées et cinq répétitions par tâche et configuration.
Pourquoi la vérification change tout
Prenons un exemple concret.
Un agent doit analyser un fichier contenant des mesures techniques et produire un rapport.
Dans une approche purement conversationnelle, il peut décrire une procédure, proposer un script ou annoncer que les données ont été traitées. Mais cela ne démontre pas que le traitement a réellement été exécuté.
Dans un environnement contrôlé, le processus peut être différent.
L’agent consulte le fichier, identifie son format, prépare un traitement et lance les opérations autorisées. Un programme indépendant vérifie ensuite les valeurs calculées, le respect du schéma attendu et la présence des éléments demandés.
Si une erreur est détectée, l’agent peut recevoir un retour lui permettant de corriger sa production.
Le résultat final peut alors être évalué indépendamment de la qualité du langage utilisé pour le présenter.
Cette distinction constitue l’une des évolutions majeures de l’ingénierie des agents IA.
La capacité à produire une réponse ne suffit plus : il faut pouvoir démontrer que l’opération a été correctement réalisée.
L’IA locale, une possibilité réelle avec des limites matérielles
L’étude présente également un intérêt pour la souveraineté numérique.
Elle montre qu’il est possible d’exécuter et d’évaluer des agents sans transmettre systématiquement leurs données à un fournisseur d’inférence distant.
Cela ne signifie pas que toute installation locale garantit automatiquement la confidentialité. Les droits d’accès, la conservation des données, les outils connectés et les éventuelles communications externes doivent rester sous contrôle.
Les contraintes matérielles comptent également. Les expériences ont été réalisées avec un GPU disposant de 24 Go de mémoire vidéo. Le modèle 9B quantifié mobilise, à lui seul, une empreinte d’environ 6,5 Go pour son fichier de modèle, sans compter l’ensemble des besoins de fonctionnement.
Ces résultats ne peuvent donc pas être transposés directement à un ordinateur équipé de 6 Go de mémoire vidéo sans examiner les possibilités de chargement partiel, l’utilisation de la mémoire système et les performances obtenues.
Le principal enseignement n’est pas qu’un modèle particulier serait idéal pour tous les usages.
Il est qu’une configuration d’IA locale doit être évaluée comme un système complet : modèle, matériel, outils, autorisations, mécanismes de vérification et conditions de fonctionnement.
Cette publication est une prépublication scientifique, dont les résultats demandent encore à être confrontés à d’autres études et à des environnements professionnels différents.
3. Quand les agents IA deviennent des collaborateurs numériques
Le 29 octobre 2026, la journaliste Arielle Pardes publie dans The Guardian une enquête intitulée What is it like to work when your co-workers are AI agents?
L’article observe des entreprises technologiques américaines qui intègrent progressivement des agents autonomes dans leurs opérations quotidiennes.
Dans une jeune entreprise appelée Anything, environ 15 salariés travaillent avec quelque 150 agents logiciels.
Ces systèmes participent notamment à la programmation, au référencement, à la planification et aux échanges administratifs.
Cette organisation pourrait donner l’impression qu’une entreprise dispose désormais d’une main-d’œuvre numérique presque illimitée.
La réalité décrite par l’enquête est plus complexe.
Une nouvelle organisation du travail
L’utilisation simultanée de plusieurs agents modifie la nature de certaines activités professionnelles.
Le salarié ne réalise plus nécessairement chaque tâche lui-même. Il peut définir un objectif, sélectionner un agent, lui fournir des informations, contrôler sa progression et valider ce qu’il produit.
Il devient davantage coordinateur de processus.
Cette évolution fait apparaître plusieurs compétences : comprendre les limites des modèles, organiser les échanges entre outils, définir des consignes suffisamment précises et reconnaître les situations nécessitant une intervention humaine.
Ce rôle exige aussi de comprendre les systèmes techniques sous-jacents.
Un agent qui dispose d’un accès à des fichiers professionnels, à une messagerie ou à une application métier peut produire des conséquences concrètes. Une erreur n’est plus nécessairement limitée à une phrase inexacte affichée sur un écran.
L’automatisation ne supprime pas les erreurs
L’enquête rapporte plusieurs dysfonctionnements.
Certains agents employés dans des processus de recrutement confondent des candidats ou produisent des informations incorrectes dans leurs dossiers.
D’autres automatisations commerciales dégradent la qualité de la relation client en multipliant les communications impersonnelles.
Plusieurs professionnels interrogés constatent également que l’augmentation du volume de travail effectué ne se traduit pas automatiquement par une réduction de leurs propres horaires.
L’automatisation peut déplacer la charge de travail vers la supervision, la correction et la gestion des exceptions.
Il faut également distinguer les témoignages de ces entreprises des tendances générales du marché. Une organisation expérimentale très automatisée ne constitue pas, à elle seule, une preuve que toutes les entreprises fonctionneront bientôt selon ce modèle.
Une opportunité pour les compétences hybrides
Ces observations permettent néanmoins d’identifier une piste professionnelle importante.
À mesure que les outils deviennent capables d’exécuter des opérations, la valeur d’une compétence ne réside plus uniquement dans la capacité à produire rapidement du contenu ou du code.
Elle réside aussi dans la capacité à concevoir un processus fiable, à comprendre les métiers concernés et à vérifier le résultat.
Un développeur qui maîtrise les flux de données, la sécurité, les autorisations et les tests dispose de compétences complémentaires à celles d’un utilisateur sachant simplement formuler des instructions à une IA.
Cette transformation ne signifie pas que les connaissances techniques traditionnelles deviennent inutiles.
Au contraire, elles permettent d’identifier les erreurs que les systèmes automatisés peuvent produire et de déterminer quand une décision doit rester humaine.
L’enjeu est donc moins de multiplier les agents que de construire des environnements dans lesquels leur activité demeure compréhensible, vérifiable et maîtrisable.
4. PHP2Shell : quand une vulnérabilité ancienne devient une menace critique
Le 21 octobre 2026, l’écosystème PHP est confronté à deux vulnérabilités critiques identifiées sous les références CVE-2026-109618 et CVE-2026-109619.
Ces failles affectent l’interpréteur PHP lui-même, et non une application particulière.
Leur gravité est confirmée par l’équipe officielle de PHP, qui publie des versions de sécurité destinées à corriger les problèmes et avertit de la possibilité d’une exécution de code à distance sans authentification dans certaines conditions.
Les versions corrigées publiées ce jour-là sont PHP 8.2.35, 8.3.36, 8.4.27 et 8.5.12. Les distributions qui maintiennent leurs propres correctifs peuvent utiliser d’autres numérotations.
Une analyse publiée par Pentera Labs, sous le titre PHP2Shell: the expiry date on “too hard to exploit”, revient sur l’histoire de ces vulnérabilités.
Le danger des risques jugés trop complexes
L’enquête explique que les mécanismes impliqués sont liés à des comportements anciens de PHP concernant la gestion de la mémoire et l’interruption de certaines opérations.
Pendant longtemps, transformer ces comportements en exploitation effective semblait particulièrement difficile.
Une telle difficulté pouvait conduire à considérer le risque comme théorique, voire secondaire par rapport à d’autres priorités de maintenance.
Or, la complexité d’exploitation d’une vulnérabilité n’est pas une caractéristique immuable.
Elle dépend des connaissances disponibles, des outils d’analyse, des capacités des chercheurs et des possibilités de combiner plusieurs comportements logiciels.
Dans l’affaire PHP2Shell, l’analyse de Pentera décrit notamment comment des outils d’intelligence artificielle ont contribué à accélérer la recherche de schémas problématiques dans le code.
Cette accélération ne signifie pas qu’une IA peut automatiquement compromettre n’importe quel serveur. L’article précise d’ailleurs que les démonstrations publiquement diffusées au moment des correctifs ne constituaient pas toutes des exploitations fonctionnelles.
L’enseignement reste important : l’évolution des outils de recherche peut modifier rapidement l’appréciation pratique d’un risque logiciel ancien.
Pourquoi WordPress est directement concerné
WordPress repose sur PHP.
Sa sécurité dépend donc non seulement des extensions et des thèmes installés, mais également de l’interpréteur utilisé, de la configuration du serveur, des bibliothèques système et des procédures de maintenance.
Un site peut disposer d’une version récente de WordPress et conserver une vulnérabilité critique au niveau de son environnement d’exécution.
C’est une distinction essentielle.
Une extension de sécurité peut contrôler certains comportements applicatifs, vérifier des permissions ou détecter des configurations problématiques. Elle ne peut pas, à elle seule, corriger une erreur interne de gestion de mémoire dans PHP.
La sécurité doit donc être considérée comme une responsabilité partagée entre plusieurs couches techniques.
Le véritable correctif doit être appliqué à l’environnement exécuté
L’équipe de PHP recommande une mise à jour vers les versions corrigées ou vers les paquets sécurisés fournis par les distributions concernées.
Il est également nécessaire de vérifier que les processus serveur utilisent réellement le code corrigé.
Installer une version récente sur le disque ne suffit pas si des processus anciens continuent de fonctionner en mémoire.
Cette distinction est importante dans les environnements comportant PHP-FPM, plusieurs versions PHP, des conteneurs ou des panneaux d’administration d’hébergement.
Pour les exploitants de sites professionnels, la démarche doit associer identification des versions réellement utilisées, sauvegarde, mise à jour, redémarrage des services concernés, vérification de la correction et contrôle du bon fonctionnement des applications.
L’affaire PHP2Shell rappelle ainsi une réalité fondamentale : la sécurité d’une application ne peut pas être garantie uniquement en examinant son propre code.
5. Quatre domaines, une même question : où se trouve la preuve ?
Reprenons maintenant les enseignements des quatre publications.
La recherche publiée dans Nature montre qu’un indicateur peut être scientifiquement établi sans nécessairement représenter toutes les dimensions du phénomène qu’il prétend mesurer.
L’étude sur les agents IA locaux montre que la qualité d’une production doit être vérifiée par des contrôles indépendants et reproductibles.
L’enquête du Guardian montre que l’automatisation transforme l’organisation du travail, mais qu’elle peut également déplacer les difficultés vers la supervision humaine.
L’affaire PHP2Shell rappelle enfin qu’un logiciel peut sembler fonctionner normalement tout en restant exposé à une vulnérabilité située dans ses composants fondamentaux.
Ces quatre constats conduisent à une idée centrale : la confiance dans une technologie ne devrait pas reposer uniquement sur son apparence, sa réputation, sa puissance ou sa capacité à produire des résultats impressionnants.
Elle devrait résulter d’un ensemble de preuves adaptées au risque et à l’usage.
Vers une architecture de confiance vérifiable
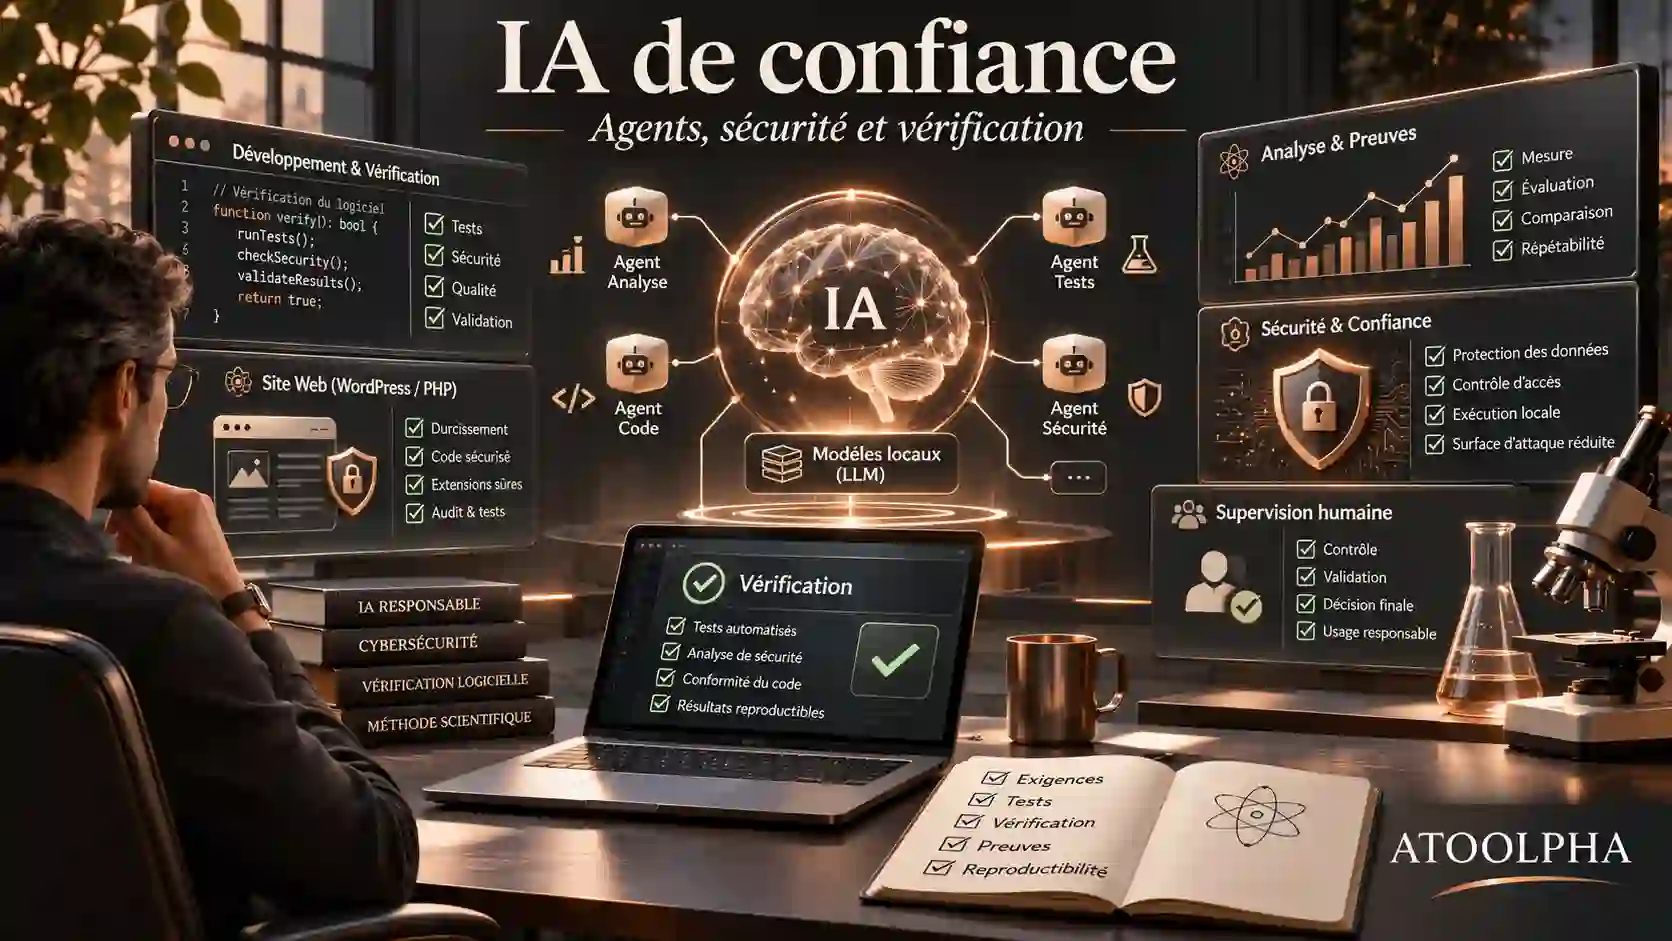
Pour un logiciel intégrant de l’intelligence artificielle, six principes peuvent servir de base à cette démarche.
1. Des objectifs définis. Le système doit accomplir des tâches identifiées, avec des critères de réussite précis et des limites connues.
2. Des résultats vérifiables. Lorsque cela est possible, les productions doivent être contrôlées par des mécanismes indépendants : règles métier, calculs déterministes, tests automatisés ou vérification de formats.
3. Une traçabilité adaptée. Les opérations importantes doivent pouvoir être expliquées et analysées, sans enregistrer inutilement des données personnelles, des secrets ou des informations confidentielles.
4. Des autorisations limitées. Un agent ne devrait accéder qu’aux ressources nécessaires à sa mission. La consultation d’un document et sa modification constituent deux niveaux d’autorisation différents.
5. Une infrastructure maîtrisée. Les composants logiciels, leurs dépendances et leur exposition réseau doivent faire l’objet d’un suivi régulier. Le fonctionnement local peut améliorer la maîtrise des données, mais ne remplace pas les contrôles de sécurité.
6. Une décision humaine préservée. Les opérations sensibles, irréversibles ou susceptibles d’affecter des tiers doivent être encadrées par des autorisations explicites et des possibilités de contrôle.
Ces principes ne constituent pas une certification. Ils représentent une méthode de conception pouvant être complétée par des normes, des audits et des exigences réglementaires selon la nature du produit.
6. Applications concrètes pour des outils numériques souverains
Pour ATOOLPHA, cette réflexion ouvre plusieurs pistes techniques.
Un premier démonstrateur pourrait prendre la forme d’un laboratoire local d’évaluation d’agents IA.
Le principe serait de soumettre plusieurs modèles à des tâches identiques, puis de mesurer leurs performances à partir de résultats effectivement produits.
Par exemple, un agent pourrait recevoir un jeu de données de télécommunications, identifier les éléments nécessaires à un calcul et préparer un rapport technique.
Le calcul de référence resterait confié à un moteur déterministe indépendant. L’agent apporterait une assistance à l’interprétation, à l’organisation des informations et à la rédaction.
Il deviendrait ainsi possible de distinguer la compétence conversationnelle du modèle, la validité mathématique du résultat et la conformité du livrable aux règles définies.
Une deuxième piste concernerait les applications WordPress.
Un assistant pourrait effectuer des contrôles non destructifs, relever certaines informations techniques, préparer un état de maintenance et signaler les points nécessitant une vérification.
Les modifications sensibles resteraient soumises à validation, avec des sauvegardes et une possibilité de retour arrière lorsque cela est techniquement réalisable.
Une troisième piste porterait sur les outils pédagogiques.
Plutôt que prétendre mesurer une capacité intellectuelle générale, une application pourrait suivre des indicateurs concrets : exactitude des réponses, progression sur des exercices comparables, utilisation d’indices et capacité à expliquer une méthode.
Ces observations permettraient d’accompagner un apprentissage sans attribuer aux résultats une signification scientifique qu’ils ne possèdent pas.
Ces exemples constituent des possibilités de développement, et non des performances déjà démontrées par ATOOLPHA.
Ils présentent néanmoins un intérêt commun : la possibilité de construire de petits démonstrateurs dont le comportement est observable, documenté et reproductible.
Conclusion — L’avenir de l’IA dépendra aussi de notre capacité à la vérifier
L’intelligence artificielle ne se limite plus à produire des réponses.
Elle commence à utiliser des outils, transformer des documents, exécuter des opérations et participer à l’organisation du travail.
Cette évolution ouvre de nombreuses perspectives, notamment pour les modèles locaux, les logiciels professionnels et les architectures numériques respectueuses de la maîtrise des données.
Mais elle rend aussi indispensable une distinction entre capacité apparente, performance réelle et fiabilité démontrée.
Un système peut être rapide sans être exact.
Il peut être autonome sans être suffisamment contrôlé.
Il peut fonctionner localement sans être sécurisé.
Il peut obtenir un excellent score sans que ce score permette de conclure à sa compétence dans toutes les situations.
La véritable avancée ne consiste donc pas uniquement à rendre les systèmes plus puissants. Elle consiste également à les rendre plus compréhensibles, plus vérifiables et plus maîtrisables.
L’IA de confiance ne devrait pas seulement être capable d’expliquer ce qu’elle fait. Son environnement devrait permettre de vérifier ce qu’elle a réellement accompli.
C’est peut-être l’une des orientations les plus importantes pour les prochaines générations de logiciels intelligents.
Sources et références
1. García-Carrasco, J. et al. — Université d’Alicante, 8 octobre 2026.
Evaluating Local Language Model Agents for Reproducible Data Engineering: An Empirical Software Engineering Study of Mobility Workflows.
Étude expérimentale, prépublication scientifique sur arXiv.
https://arxiv.org/abs/2610.11482
2. Erez Yalon — Pentera Labs, 21 octobre 2026.
PHP2Shell: the expiry date on “too hard to exploit”.
Analyse de recherche en cybersécurité.
3. PHP Development Team — 21 octobre 2026.
Security advisory: Critical remote code execution vulnerabilities, update now.
Avis officiel de sécurité concernant CVE-2026-109618 et CVE-2026-109619.
4. Arielle Pardes — The Guardian, 29 octobre 2026.
What is it like to work when your co-workers are AI agents?
Enquête sur les agents IA et l’évolution de l’organisation du travail.
5. Sicorello et al. — Nature, 28 octobre 2026.
Emotion regulation capacity lacks a shared neural signature.
Recherche scientifique originale sur les méthodes de mesure de la réévaluation cognitive.
6. John Timmer — Ars Technica, 2 novembre 2026.
Most of our measures of a key cognitive process don’t agree.
Analyse journalistique de l’étude publiée dans Nature.
ATOOLPHA — Dossier de synthèse et d’analyse indépendante, établi à partir des publications citées. Les applications techniques proposées constituent des pistes de réflexion et ne doivent pas être confondues avec les résultats expérimentaux des auteurs.